Biến Văn Bản Thành Sách Nói Bằng AI: Tự Làm Audiobook Với VoiceStudio Chạy Local
Mục lục
- 1. Nhu Cầu Sách Nói Và Cơn Đau Đầu Về Chi Phí Bản Quyền / Credit TTS
- 2. VoiceStudio Là Gì? “ElevenLabs Thu Nhỏ” Chạy 100% Offline Đạt 50.000 Stars
- 3. Pipeline 3 Tầng: Từ Bản Thảo Thô Đến Sách Nói Hoàn Chỉnh Chuẩn Phòng Thu
- 3.1. Tầng Tiền xử lý (AI Agent Pre-processing)
- 3.2. Tầng Sinh giọng nói (VoiceStudio Local Engine)
- 3.3. Tầng Hậu kỳ & Đóng gói (Audio Stitching & Mastering)
- 4. Bí Quyết Zero-Shot Voice Cloning: Tạo Giọng Đọc Độc Bản Chỉ Từ 10 Giây Audio
- 5. Bảng Đối Chiếu: VoiceStudio Chạy Local vs ElevenLabs Cloud vs Thuê Studio Thu Âm
- 6. Hướng Dẫn Cài Đặt Và Vận Hành VoiceStudio Trên Máy Tính (Windows & Mac)
- Bước 1: Tải bộ cài Desktop App chính thức
- Bước 2: Tải gói mô hình đa ngôn ngữ (Multilingual Weights)
- Bước 3: Nạp kịch bản và chạy render hàng loạt
- 7. Chiến Lược Tái Sử Dụng Nội Dung: 1 Cuốn Sách Nói Sinh Ra Đa Kênh Truyền Thông
- 8. Câu Hỏi Thường Gặp (FAQ) Về Tạo Sách Nói Bằng AI Chạy Local
- 1. Máy tính của tôi không có card đồ họa rời (GPU) thì có chạy được VoiceStudio không?
- 2. Giọng đọc tiếng Việt tạo ra có bị ngọng dấu ngã và dấu hỏi không?
- 3. Sách nói tạo bằng VoiceStudio có được phép đăng lên Spotify hoặc YouTube để bật kiếm tiền không?
- 4. Tôi có thể dịch một cuốn sách tiếng Anh sang tiếng Việt rồi lồng tiếng luôn được không?
Để biến văn bản thành sách nói bằng AI dài tập với chất lượng phòng thu, bạn không cần phải trả hàng trăm đô la mua credit trên ElevenLabs hay thuê phòng thu đắt đỏ. Bằng cách kết hợp AI Agent (Claude Code / Antigravity) để tiền xử lý lọc rác văn bản và phần mềm mã nguồn mở VoiceStudio (debpalash/VoiceStudio, hơn 50.000+ stars) chạy 100% offline trên máy tính, bạn có thể tự sao chép (clone) giọng đọc tiếng Việt truyền cảm chỉ từ 10 giây ghi âm mẫu, render hàng chục nghìn từ mà không tốn một đồng chi phí bản quyền và tự động xuất file phụ đề
.srt đồng bộ.
Hãy tưởng tượng bạn đang nắm trong tay một tài sản nội dung giá trị: một cuốn sách kinh doanh dày 200 trang, một tập tài liệu hướng dẫn kỹ thuật chuyên sâu, hoặc hàng chục bài viết blog chất lượng cao đã dày công biên soạn. Bạn rất muốn người dùng có thể tiếp cận chúng dưới dạng sách nói (Audiobook) hoặc Podcast để họ vừa lái xe, vừa chạy bộ vừa tiếp thu kiến thức.
Thế nhưng, khi bắt tay vào triển khai thực tế, bạn lập tức va phải ba bức tường lớn:
- Thuê phòng thu chuyên nghiệp: Chi phí cho một cuốn sách nói hoàn chỉnh thường dao động từ 15 đến 40 triệu đồng cho khâu phát thanh viên và hậu kỳ âm thanh, kèm theo thời gian chờ đợi hàng tuần lễ.
- Dùng dịch vụ đám mây như ElevenLabs: Dù giọng đọc rất hay nhưng chi phí tính theo ký tự (token/credit) cực kỳ đắt đỏ. Một cuốn sách 50.000 từ có thể ngốn từ 50$ đến 150$ chỉ cho một lần render; nếu bạn muốn sửa đổi vài câu từ thì lại phải trả tiền lại từ đầu. Chưa kể rủi ro rò rỉ các tài liệu nội bộ mật lên máy chủ đám mây của bên thứ ba.
- Các công cụ TTS miễn phí thông thường: Giọng đọc khô khan, ngắt nghỉ tùy tiện, phát âm tiếng Việt như robot năm 2010 và thường xuyên đọc lẫn cả số trang, chú thích chân trang gây ức chế cho người nghe.
Sự kết hợp giữa AI Agent biên tập và công cụ mã nguồn mở VoiceStudio sinh ra để giải quyết triệt để nghịch lý này: mang lại chất lượng âm thanh đẳng cấp tương đương các nền tảng thương mại hàng đầu, nhưng vận hành hoàn toàn cục bộ (local-first) trên máy tính của bạn với chi phí 0 đồng.
1. Nhu Cầu Sách Nói Và Cơn Đau Đầu Về Chi Phí Bản Quyền / Credit TTS
Hành vi tiếp nhận thông tin đang dịch chuyển mạnh sang nghe thụ động (Audio Multitasking). Việc tự chủ một hệ thống tạo sách nói chạy cục bộ giúp doanh nghiệp và tác giả tiết kiệm hàng ngàn đô la chi phí credit đám mây và bảo vệ tuyệt đối bản quyền nội dung.
Trong nhịp sống bận rộn ngày nay, thời gian ngồi yên trước màn hình để đọc một cuốn sách hay tài liệu dài đang ngày càng co hẹp. Thay vào đó, người dùng chuyển sang trạng thái “tiếp thu đa nhiệm” (Audio Multitasking): nghe kiến thức khi đang lái xe trên đường, khi đi bộ tập thể dục buổi sáng, hoặc trước khi đi ngủ. Nếu nội dung của bạn chỉ nằm im dưới dạng chữ viết (text), bạn đang bỏ lỡ hơn một nửa dung lượng tiếp cận độc giả tiềm năng.
Thế nhưng, khi thử dùng các giải pháp Text-to-Speech (TTS) thương mại trên đám mây, các nhà sáng tạo nội dung nhanh chóng nhận ra “cái bẫy chi phí”:
- Cơ chế tính phí lũy tiến: Các nền tảng đám mây thu tiền trên từng ký tự (character-based pricing). Một cuốn sách thông thường chứa khoảng 300.000 đến 500.000 ký tự. Chỉ cần một lần nghe thử thấy chưa ưng ý và nhấn render lại, hóa đơn thẻ tín dụng của bạn đã bị trừ thêm một khoản tiền đáng kể.
- Giới hạn ngắt quãng theo phiên: Hầu hết các API đám mây giới hạn độ dài mỗi yêu cầu dưới 5.000 ký tự. Để làm một cuốn sách dài, bạn phải tự tay copy paste từng mẩu nhỏ, ghép nối thủ công hàng trăm file mp3 rời rạc – một công việc tẻ nhạt và cực kỳ dễ nhầm lẫn.
- Bảo mật tài liệu chưa công bố: Bạn có dám tải bản thảo cuốn sách sắp xuất bản hay báo cáo tài chính nội bộ công ty lên một máy chủ không rõ vị trí vật lý để chuyển thành giọng nói? Câu trả lời của hầu hết các doanh nghiệp nghiêm túc là không.
Đó là lý do mô hình Local-First AI (chạy AI trực tiếp trên phần cứng máy tính) đang trở thành tiêu chuẩn mới: phần mềm thuộc về bạn, dữ liệu nằm trên ổ cứng của bạn, và bạn có quyền tạo ra hàng nghìn giờ sách nói mà không phải nhìn vào đồng hồ tính phí credit.
2. VoiceStudio Là Gì? “ElevenLabs Thu Nhỏ” Chạy 100% Offline Đạt 50.000 Stars
VoiceStudio là bộ công cụ mã nguồn mở phát triển bởi Palash Deb (hơn 50.000+ stars trên GitHub) đóng gói sức mạnh của ElevenLabs vào một ứng dụng máy tính chạy hoàn toàn offline, tích hợp sẵn tính năng làm sách nói, sao chép giọng nói và hỗ trợ tiếng Việt mượt mà.
Dự án VoiceStudio (trước đây được cộng đồng biết đến với tên gọi OmniVoice Studio) do nhà phát triển Palash Deb khởi xướng đã tạo nên một làn sóng chấn động trong giới mã nguồn mở vào năm 2026. Chỉ trong một thời gian ngắn, dự án đã chạm mốc hơn 50.000 lượt yêu thích (stars) trên GitHub và trở thành công cụ dòng lệnh lẫn ứng dụng đồ họa (desktop app) được tải về nhiều nhất trong danh mục xử lý âm thanh AI.
Sở dĩ VoiceStudio được mệnh danh là “ElevenLabs chạy trên máy cá nhân” bởi nó giải quyết trọn vẹn 4 tính năng tinh hoa nhất mà trước đây chỉ có các dịch vụ trả phí đắt đỏ mới làm được:
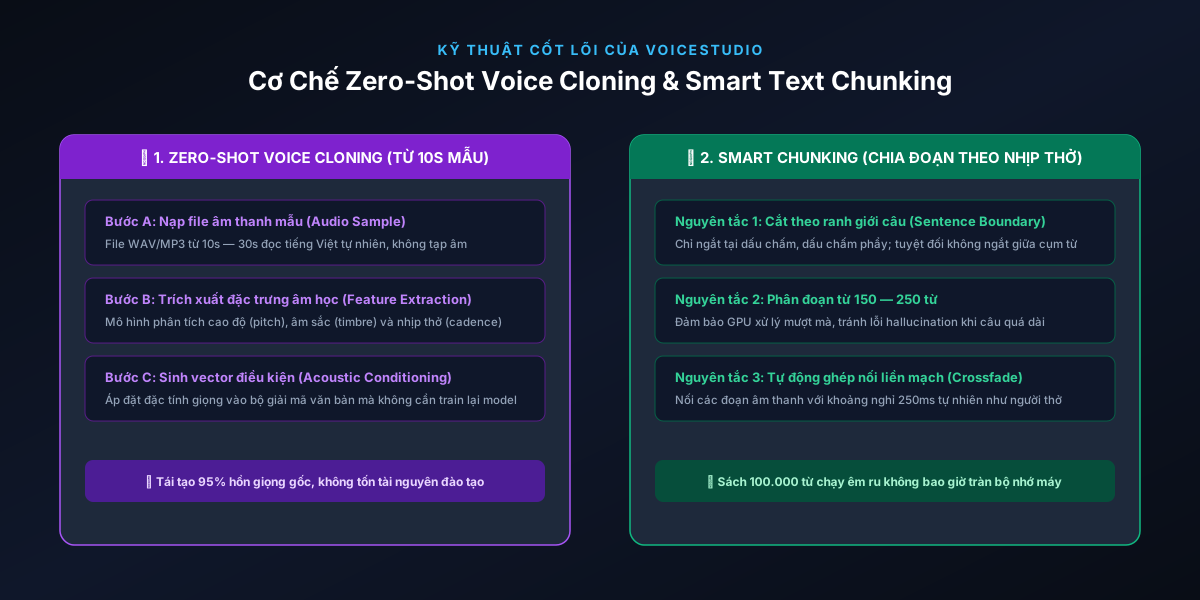
- Mô hình Zero-Shot Voice Cloning: Không cần phải đọc hàng trăm câu văn mẫu để huấn luyện lại mô hình mất nhiều ngày. Bạn chỉ cần đưa vào một đoạn ghi âm ngắn từ 10 đến 30 giây, VoiceStudio sẽ trích xuất “vân tay âm thanh” (Acoustic Embeddings) và bắt chước ngữ điệu, nhịp thở của người đó gần như ngay lập tức.
- Hỗ trợ chuẩn xác Tiếng Việt và 646 ngôn ngữ: Trái ngược với các mô hình TTS đời cũ thường đọc tiếng Việt theo kiểu lơ lớ hoặc nuốt dấu thanh, VoiceStudio áp dụng các bộ mã hóa âm vị học (phoneme tokenization) hiện đại, đọc chuẩn xác từng thanh điệu hỏi, ngã, nặng và ngữ điệu câu hỏi, câu khẳng định.
- Chuyên môn hóa cho Sách nói (Audiobook Creation Mode): Tích hợp sẵn giao diện quản lý dự án sách: tự động nhận diện các chương, quản lý nhân vật đọc thoại, ghép nối âm thanh và gắn siêu dữ liệu (metadata) trực tiếp vào file.
- Tự động xuất phụ đề đồng bộ thời gian (SRT): Trong quá trình sinh âm thanh, phần mềm tự động ghi nhận mốc thời gian (timestamp) của từng từ và xuất ra tệp
.srtchuẩn xác. Bạn có thể tận dụng ngay tệp này để tạo video chạy chữ lên YouTube hoặc TikTok mà không tốn công gõ lại phụ đề.
3. Pipeline 3 Tầng: Từ Bản Thảo Thô Đến Sách Nói Hoàn Chỉnh Chuẩn Phòng Thu
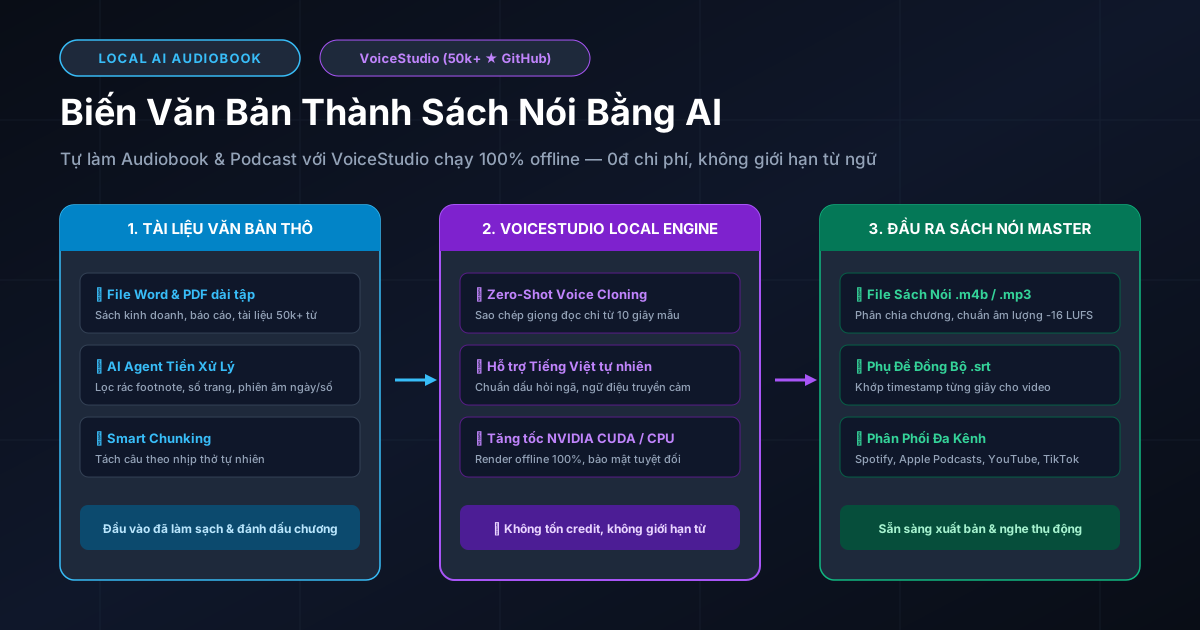
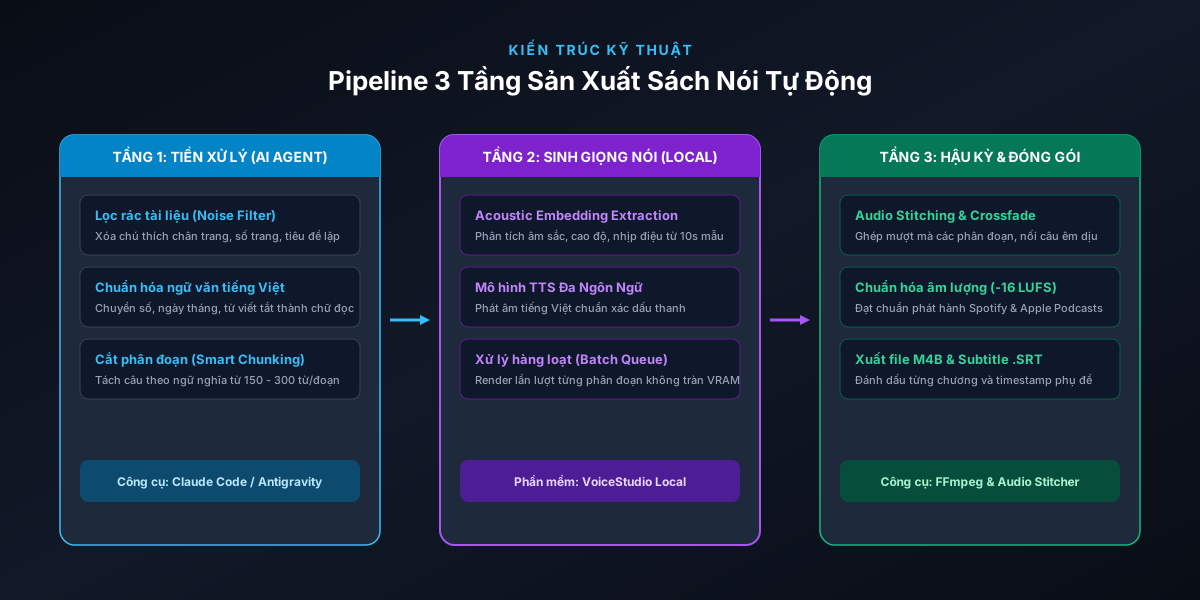
Quy trình sản xuất sách nói chuyên nghiệp gồm 3 tầng: Tầng 1 (AI Agent lọc rác footnote và phiên âm số liệu), Tầng 2 (VoiceStudio cắt phân đoạn thông minh và lồng tiếng offline hàng loạt), Tầng 3 (Hậu kỳ ghép nối và chuẩn hóa âm lượng theo chuẩn quốc tế -16 LUFS).
Để một cuốn sách nói khi nghe không bị “rác tai” và đạt chuẩn kỹ thuật để phân phối lên các nền tảng như Apple Podcasts hay Spotify, bạn không thể ném nguyên một file Word 200 trang vào phần mềm TTS. Toàn bộ quy trình cần được tổ chức thành 3 tầng tự động hóa:
3.1. Tầng Tiền xử lý (AI Agent Pre-processing)
Bản thảo sách in luôn chứa các thành phần phục vụ mắt đọc nhưng phá hỏng tai nghe: số trang lặp lại ở chân trang, chú thích nguồn (footnote), tiêu đề đầu trang (header), bảng biểu số liệu phức tạp và các đường dẫn URL. Đây là lúc sức mạnh của các Coding Agent như Claude Code hoặc Antigravity phát huy tác dụng.
Agent sẽ chạy một script tự động quét qua tệp văn bản và thực hiện các nhiệm vụ sau:
- Loại bỏ rác định dạng: Tự động xóa các số trang, ký hiệu đánh dấu tham chiếu
[1], [2]và các dòng tiêu đề trùng lặp. - Chuẩn hóa ngữ văn cho máy đọc: Chuyển các ký hiệu số và ngày tháng thành chữ viết rõ ràng. Ví dụ: chuỗi “25/12/2026” được đổi thành “ngày hai mươi lăm tháng mười hai năm hai nghìn không trăm hai mươi sáu”; chuỗi “$1.500” đổi thành “một nghìn năm trăm đô la”. Điều này ngăn ngừa hoàn toàn tình trạng máy đọc sai hoặc ngắc ngứ.
- Chia nhỏ thành các phân đoạn (Smart Chunking): Cắt văn bản thành các đoạn nhỏ từ 150 đến 250 từ dựa trên dấu chấm hết câu, đảm bảo khi nạp vào mô hình âm thanh không bao giờ bị vượt ngưỡng bộ nhớ VRAM.
3.2. Tầng Sinh giọng nói (VoiceStudio Local Engine)
Sau khi văn bản đã được làm sạch và chia đoạn, VoiceStudio tiếp nhận hàng đợi xử lý (Batch Queue). Quá trình này diễn ra hoàn toàn tự động:
- Phần mềm nạp file âm thanh mẫu của bạn (10s – 30s) và tạo vector đặc trưng âm học.
- Lần lượt render từng đoạn văn bản thành các tệp âm thanh định dạng WAV độ phân giải cao (24-bit, 48kHz).
- Cơ chế phân phối tài nguyên thông minh: Nếu máy có card đồ họa rời NVIDIA, phần mềm sẽ tận dụng nhân Tensor CUDA để render với tốc độ gấp 5 đến 8 lần tốc độ đọc thực tế (1 giờ sách nói chỉ mất khoảng 8-12 phút render).
3.3. Tầng Hậu kỳ & Đóng gói (Audio Stitching & Mastering)
Một lỗi thường gặp khi làm sách nói bằng AI là giữa các đoạn cắt có tiếng “bụp” nhẹ hoặc khoảng lặng quá dài khiến nhịp đọc bị rời rạc. Tầng hậu kỳ giải quyết việc này bằng các công cụ kịch bản FFmpeg:
- Nối file với kỹ thuật Crossfade nhẹ: Chèn một khoảng nghỉ tự nhiên khoảng 250ms – 350ms giữa các câu và 800ms giữa các đoạn văn, mô phỏng đúng nhịp thở của người đọc thật.
- Chuẩn hóa âm lượng (-16 LUFS): Đây là tiêu chuẩn âm lượng bắt buộc của các kho sách nói và podcast quốc tế (Apple Podcasts, Spotify). Nếu âm thanh quá nhỏ người nghe phải vặn to loa, nếu quá lớn sẽ gây vỡ tiếng méo âm.
- Đóng gói tệp sách nói có mục lục (M4B / MP3): Nhúng ảnh bìa sách (Cover Art), tên tác giả, tên cuốn sách và chia các mốc thời gian từng chương (Chapter Markers) để người nghe có thể nhấn nhảy chương trên ứng dụng điện thoại.
4. Bí Quyết Zero-Shot Voice Cloning: Tạo Giọng Đọc Độc Bản Chỉ Từ 10 Giây Audio
Công nghệ Zero-shot Voice Cloning trích xuất vân tay âm thanh từ file mẫu ngắn mà không cần đào tạo lại mô hình. Để giọng clone đọc sách hay, mẫu thu âm cần rõ tiếng, không vang vọng phòng, đọc truyền cảm và đúng phong cách tự sự của sách nói.
Một trong những rào cản lớn nhất của sách nói AI trước đây là người nghe cảm thấy “nhạt” vì hàng ngàn cuốn sách đều dùng chung một vài giọng đọc mặc định có sẵn. Với VoiceStudio, bạn có thể biến chính giọng nói của mình (hoặc giọng của một chuyên gia mà bạn hợp tác) thành phát thanh viên đọc trọn vẹn cuốn sách.
Để đạt được độ giống và độ tự nhiên cao nhất khi clone giọng tiếng Việt, bạn nên tuân thủ 3 nguyên tắc chọn file mẫu sau:
- Độ dài lý tưởng: Mặc dù VoiceStudio quảng cáo có thể clone từ 10 giây, nhưng độ dài tối ưu cho sách nói dài tập là từ 20 đến 45 giây. Thời lượng này vừa đủ để mô hình nắm bắt được cách ngân dài ở cuối câu và nhịp điệu thở tự nhiên của bạn.
- Môi trường ghi âm sạch tiếng: Thu âm trong phòng kín có rèm che hoặc tủ quần áo để triệt tiêu tiếng vang (reverb). Tuyệt đối không để lọt tiếng quạt gió, tiếng gõ bàn phím hoặc nhạc nền trong file mẫu, vì AI sẽ hiểu nhầm tiếng ồn đó là một phần của giọng nói và tái tạo tiếng xì xào trong suốt cuốn sách.
- Đọc đúng phong thái kể chuyện: Nếu bạn ghi âm file mẫu với giọng hào hứng, gấp gáp như đang livestream bán hàng, AI sẽ dùng chính nhịp độ đó để đọc một cuốn sách triết học sâu lắng! Hãy đọc đoạn mẫu một cách điềm tĩnh, ấm áp và có chiều sâu đúng phong cách bạn muốn cuốn sách thể hiện.
Công nghệ Voice Cloning mở ra tiềm năng to lớn nhưng cũng tiềm ẩn rủi ro lạm dụng. Bạn chỉ nên sao chép giọng nói của chính bạn, hoặc giọng đọc của người đã ký văn bản ủy quyền đồng ý rõ ràng. Việc tự ý trích xuất giọng của phát thanh viên nổi tiếng hoặc người khác để phát hành sách thương mại là hành vi vi phạm nghiêm trọng luật sở hữu trí tuệ và quyền nhân thân.
5. Bảng Đối Chiếu: VoiceStudio Chạy Local vs ElevenLabs Cloud vs Thuê Studio Thu Âm
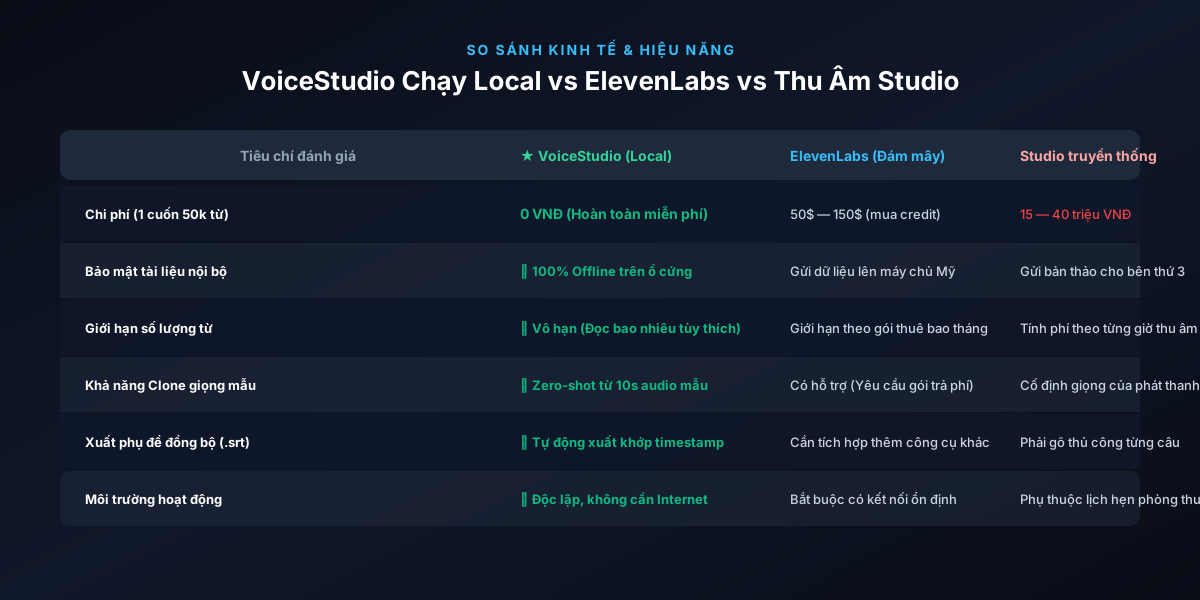
VoiceStudio mang lại hiệu quả vượt trội về mặt kinh tế (0 đồng chi phí vận hành), bảo mật tuyệt đối dữ liệu nội bộ trên ổ cứng và tự do render không giới hạn độ dài cuốn sách so với các giải pháp thuê ngoài hay dịch vụ đám mây.
Bảng đối chiếu dưới đây giúp bạn có cái nhìn tổng quan về sự đánh đổi giữa ba phương án sản xuất sách nói phổ biến nhất hiện nay:
6. Hướng Dẫn Cài Đặt Và Vận Hành VoiceStudio Trên Máy Tính (Windows & Mac)
Bạn chỉ cần tải bản phát hành Desktop App của VoiceStudio trên GitHub, khởi chạy ứng dụng, chọn chế độ tăng tốc GPU CUDA (hoặc CPU), tải gói trọng số mô hình đa ngôn ngữ và nạp bản thảo để bắt đầu xuất bản sách nói.
Việc triển khai VoiceStudio ngày nay rất thân thiện, bạn không cần phải là chuyên gia lập trình Python mới có thể vận hành được:
Bước 1: Tải bộ cài Desktop App chính thức
Truy cập vào trang phát hành mã nguồn mở của dự án trên GitHub: https://github.com/debpalash/VoiceStudio/releases. Tải về gói cài đặt phù hợp với hệ điều hành của bạn:
- Dành cho Windows: Tải tệp cài đặt
VoiceStudio-Setup-x64.exe. - Dành cho macOS: Tải tệp
VoiceStudio-arm64.dmg(hỗ trợ tối ưu cho các chip Apple M1/M2/M3/M4 qua nền tảng MLX).
Bước 2: Tải gói mô hình đa ngôn ngữ (Multilingual Weights)
Khi mở ứng dụng lần đầu tiên, giao diện sẽ hỏi bạn tải gói mô hình âm thanh. Hãy chọn gói Multilingual TTS & Voice Cloning (khoảng 5GB – 8.5GB). Việc tải này chỉ thực hiện một lần duy nhất, sau đó phần mềm sẽ ngắt hoàn toàn kết nối mạng và hoạt động offline độc lập.