Xây Dựng Second Brain Cho AI Agent: Kết Hợp Graphify, Obsidian & Claude Code Tạo Đồ Thị Tri Thức
Second Brain cho AI Agent là một kho tri thức bằng file mà cả bạn lẫn AI đều có thể đọc, kiểm tra và cập nhật. Một cách triển khai thực tế là dùng Obsidian để lưu Markdown, claude-obsidian để biến tài liệu thô thành ghi chú có nguồn, và Graphify để lập bản đồ quan hệ trong codebase hoặc kho tài liệu. Ba công cụ bổ sung cho nhau, nhưng không phải một bộ cài “bấm nút là chạy”: bạn vẫn cần quy ước thư mục, kiểm soát thay đổi và chọn rõ dữ liệu nào được gửi tới mô hình AI.
Mục lục
- 1. Second Brain cho AI Agent khác gì một thư mục ghi chú?
- 2. Vì sao grep và Vector RAG chưa đủ cho mọi bài toán?
- 3. Graphify là gì và giới hạn của nó nằm ở đâu?
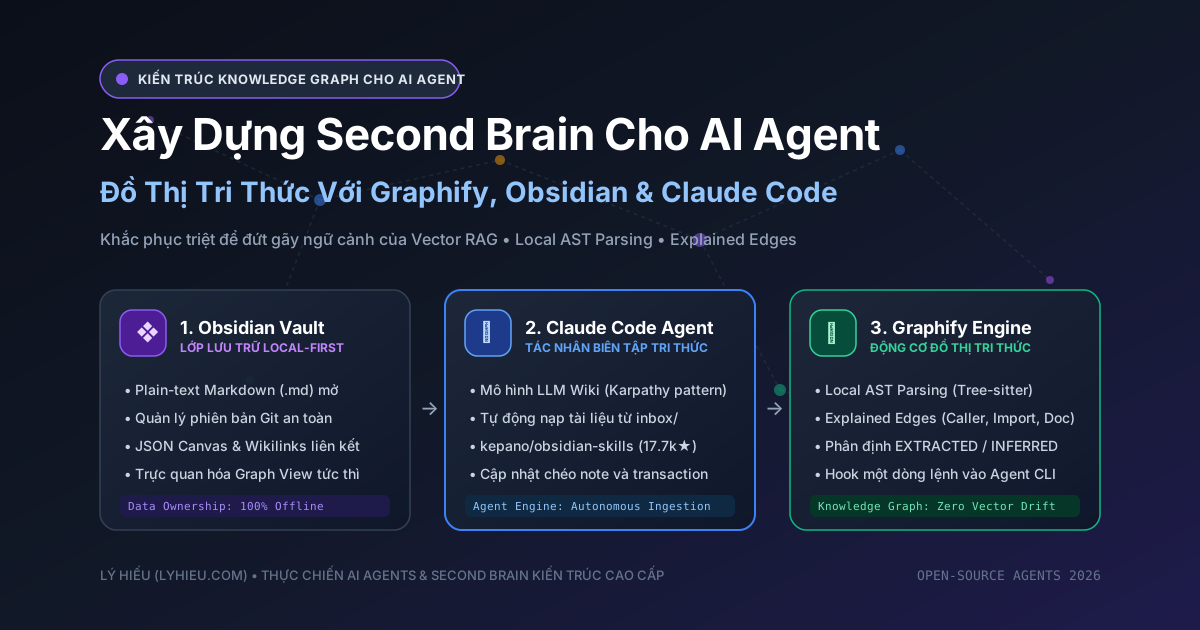
- 4. Kiến trúc ba lớp: Obsidian, Agent và Graphify
- Lớp 1: Obsidian Vault giữ dữ liệu gốc
- Lớp 2: Agent biến tài liệu thành ghi chú có thể dùng lại
- Lớp 3: Graphify cung cấp bản đồ quan hệ
- 5. Obsidian Skills giúp Agent viết đúng định dạng vault
- 6. Cách dựng bản thử nghiệm an toàn
- Bước 1: Tạo vault và điểm khôi phục
- Bước 2: Cài claude-obsidian hoặc liên kết skill cho Agent đang dùng
- Bước 3: Cài Graphify và lập chỉ mục
- Bước 4: Thử một vòng ingest nhỏ
- 7. Khi nào nên dùng từng mảnh ghép?
- 8. Năm lỗi dễ biến Second Brain thành bãi chứa mới
- 9. Câu hỏi thường gặp
- Graphify có cần GPU không?
- Graphify có thay Vector RAG không?
- Dữ liệu có hoàn toàn ở trên máy không?
- Có nên dùng GitHub private để đồng bộ vault?
- Kết luận: xây bản đồ trước khi yêu cầu AI chạy nhanh hơn
- Đọc tiếp trong cụm AI Agent
- Tài liệu kỹ thuật đã đối chiếu
Một AI coding agent có thể đọc mười file rất nhanh. Đến file thứ năm trăm, câu chuyện khác hẳn.
Quyết định kiến trúc nằm trong một ghi chú cũ. Quy tắc nghiệp vụ nằm trong tài liệu khác. Hàm đang sửa lại được gọi từ ba module mà Agent chưa mở. Nếu chỉ đưa cho AI một ô chat và hy vọng nó tự nhớ mọi thứ, bạn đang giao chìa khóa kho cho một người rất nhanh nhưng không có bản đồ.
Đó là lý do cần một Second Brain cho AI Agent: không phải chiếc não thần kỳ nhớ thay con người, mà là một hệ thống giúp Agent biết nên đọc gì, thông tin đến từ đâu và quan hệ nào cần kiểm tra trước khi sửa. Bài này tập trung vào một kiến trúc có thể tự dựng bằng ba dự án mã nguồn mở: Obsidian, claude-obsidian và Graphify.
1. Second Brain cho AI Agent khác gì một thư mục ghi chú?
Một thư mục ghi chú chỉ trả lời câu hỏi: “Tài liệu nằm ở đâu?”. Second Brain hữu ích cho Agent phải trả lời thêm ba câu: thông tin này đến từ nguồn nào, liên quan đến phần nào và thay đổi nó sẽ ảnh hưởng đến đâu.
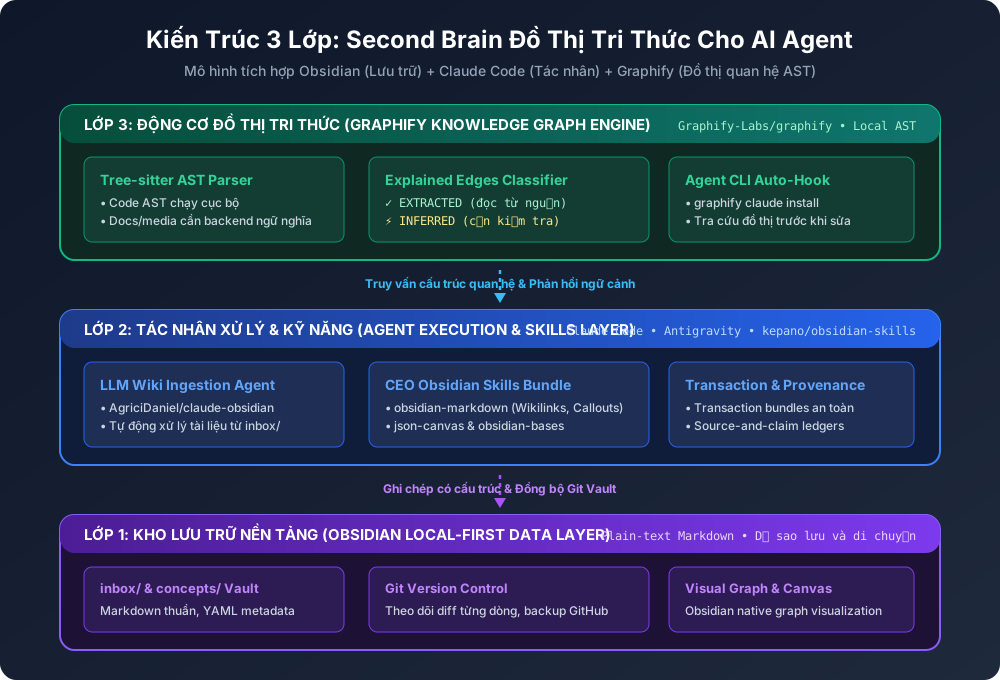
Để làm được vậy, hệ thống cần ba lớp:
- Lớp dữ liệu: file Markdown, mã nguồn, schema và tài liệu gốc có thể đọc bằng công cụ thông thường.
- Lớp biên tập: Agent trích ý, tạo liên kết, trả lời câu hỏi và đề xuất thay đổi.
- Lớp quan hệ: bản đồ cho biết file nào import file nào, hàm nào gọi hàm nào, ghi chú nào liên kết với khái niệm nào.
Obsidian phù hợp với lớp dữ liệu vì vault thực chất là các file trên máy. Claude Code hoặc một Agent tương thích với chuẩn Agent Skills đảm nhận lớp biên tập. Graphify bổ sung lớp quan hệ bằng đồ thị có thể truy vấn.
Điểm cần nhớ: “local-first” không đồng nghĩa “không bao giờ có dữ liệu rời khỏi máy”. File có thể nằm cục bộ, nhưng khi Agent dùng một mô hình đám mây để đọc chúng, nội dung được gửi tới nhà cung cấp mô hình theo cấu hình của bạn. Quyền riêng tư nằm ở cách vận hành, không nằm trong một nhãn dán đẹp.
2. Vì sao grep và Vector RAG chưa đủ cho mọi bài toán?
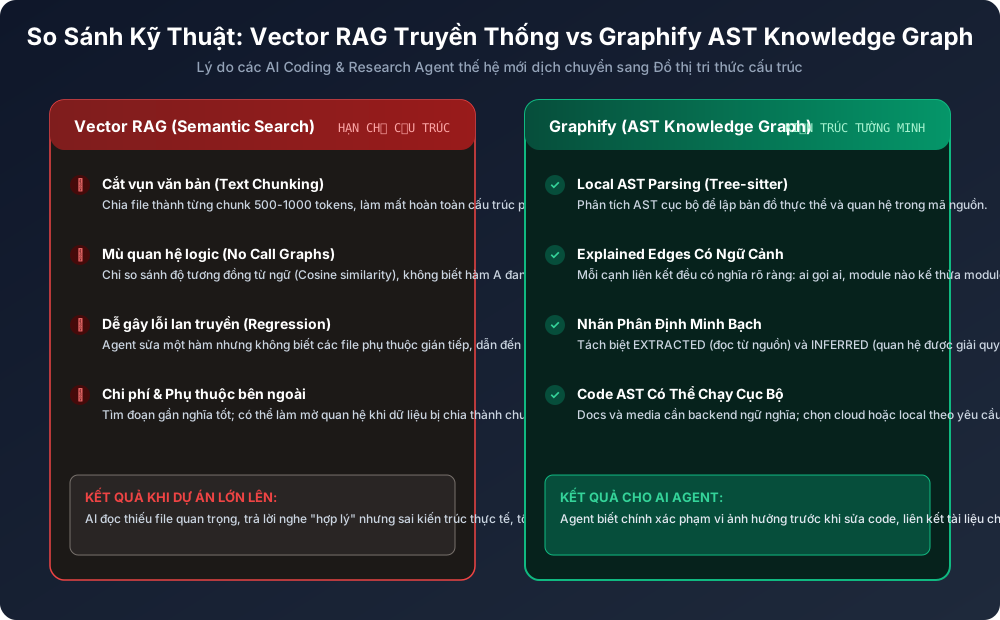
Grep, Vector RAG và Knowledge Graph giải quyết ba kiểu câu hỏi khác nhau. Chúng không phải ba thế hệ thay nhau lên ngôi.
| Công cụ | Làm tốt nhất | Điểm yếu cần biết |
|---|---|---|
| Grep / ripgrep | Tìm chuỗi, tên hàm, khóa cấu hình và vị trí xuất hiện chính xác | Không tự giải thích quan hệ kiến trúc; người hoặc Agent vẫn phải đọc kết quả |
| Vector RAG | Tìm đoạn văn có ý nghĩa gần với câu hỏi, kể cả khi từ ngữ không trùng hoàn toàn | Việc chia chunk có thể làm mờ quan hệ thứ bậc, trình tự hoặc phụ thuộc liên file |
| Knowledge Graph | Truy vấn thực thể và đường nối: ai gọi ai, file nào phụ thuộc file nào, khái niệm nào liên kết với nhau | Cần bước trích xuất và cập nhật đồ thị; quan hệ suy luận vẫn phải được kiểm tra |
Vector RAG vẫn hữu ích khi bạn cần hỏi đáp trên tài liệu dài. Grep vẫn là con dao gọn nhất khi đã biết chính xác cần tìm gì. Đồ thị quan hệ đáng dùng khi câu hỏi mang tính cấu trúc: “Nếu sửa thành phần này, những phần nào có thể bị ảnh hưởng?”
Nói nôm na: grep tìm tên người, RAG tìm người nói chuyện giống chủ đề, còn đồ thị cho bạn biết ai đang làm việc với ai. Muốn điều tra một hệ thống lớn, đôi khi cần cả ba.
3. Graphify là gì và giới hạn của nó nằm ở đâu?
Graphify là công cụ mã nguồn mở biến code, tài liệu, schema và một số loại nội dung khác thành knowledge graph có thể truy vấn. Với mã nguồn, Graphify dùng Tree-sitter AST để trích xuất quan hệ cục bộ và không cần vector store. Các cạnh trong đồ thị được ghi là EXTRACTED khi đọc trực tiếp từ nguồn hoặc INFERRED khi được giải quyết bằng suy luận của hệ thống.
Điểm đáng giá không phải là Graphify “biết tất cả”, mà là nó cho Agent một lối vào tốt hơn trước khi đọc từng file. Bạn có thể truy vấn một khái niệm, lần đường nối giữa hai thực thể hoặc yêu cầu giải thích một node thay vì ném toàn bộ repo vào context window.
Theo tài liệu chính thức, phần code được phân tích cục bộ bằng Tree-sitter. Với tài liệu, PDF, ảnh, âm thanh hoặc video, Graphify cần một bước trích xuất ngữ nghĩa qua AI assistant hoặc backend mà bạn cấu hình. Nếu muốn giữ code hoàn toàn cục bộ, có thể chạy chế độ --code-only hoặc chọn backend local như Ollama. Vì vậy, câu “Graphify luôn chạy 100% offline với mọi dữ liệu” là không đúng.
Hai nhãn cạnh cũng cần được hiểu đúng:
EXTRACTED: quan hệ được lấy trực tiếp từ nguồn, chẳng hạn một import hoặc liên kết tường minh.INFERRED: quan hệ được Graphify giải quyết từ ngữ cảnh. Nó hữu ích, nhưng không nên được xem là chân lý tuyệt đối.
Graphify có thể từ chối một tên truy vấn bị mơ hồ và trả danh sách ứng viên, nhưng đó không phải nhãn cạnh thứ ba mang tên AMBIGUOUS. Phân biệt này nhỏ trên giấy, nhưng rất lớn khi bạn dùng bài viết làm hướng dẫn kỹ thuật.
4. Kiến trúc ba lớp: Obsidian, Agent và Graphify
Ba công cụ trong bài không phải một sản phẩm tích hợp sẵn. Kiến trúc dưới đây là cách ghép chúng thành một workflow có kiểm soát.
Lớp 1: Obsidian Vault giữ dữ liệu gốc
Vault chứa ghi chú Markdown, liên kết [[wikilinks]], thuộc tính YAML và Canvas. Vì đây là file thông thường, bạn có thể mở bằng editor khác, sao lưu bằng Git hoặc chuyển sang công cụ mới nếu cần.
Đừng đưa mọi thứ vào một thư mục duy nhất. Một cấu trúc tối thiểu nên tách inbox/ cho tài liệu mới, notes/ cho ghi chú đã xử lý, projects/ cho ngữ cảnh công việc và sources/ cho bản gốc. Tên thư mục không quan trọng bằng việc người và Agent cùng hiểu một quy ước.
Lớp 2: Agent biến tài liệu thành ghi chú có thể dùng lại
claude-obsidian triển khai mô hình LLM Wiki: đưa nguồn vào inbox/, để Agent soạn ghi chú liên kết có dẫn nguồn, truy vấn lại kho kiến thức và chạy kiểm tra sức khỏe vault. Dự án dùng một cơ chế giao dịch để lập kế hoạch rồi mới ghi, kèm journal phục hồi nếu thao tác bị gián đoạn.
Điều này không biến AI thành máy kiểm chứng sự thật. README của dự án nói rõ hệ thống không phải fact checker. PDF và EPUB hiện chỉ được ghi nhận metadata, hash và kích thước; muốn trích toàn văn cần thêm công cụ. Một file PDF nằm trong inbox chưa có nghĩa Agent đã đọc được nội dung của nó.
Lớp 3: Graphify cung cấp bản đồ quan hệ
Graphify lập chỉ mục repo hoặc vault và tạo đồ thị để Agent truy vấn trước khi tìm kiếm rộng. Trên Claude Code và một số nền tảng có hook, nó có thể nhắc Agent hỏi đồ thị trước. Trên Codex, Cursor và những nền tảng dựa vào file hướng dẫn, cơ chế tích hợp có thể là quy tắc luôn bật thay vì hook chạy trước mọi lần đọc.
Đây là chỗ nhiều người dễ nhầm: đồ thị giúp định hướng, không thay thế việc mở file nguồn và chạy test. Bản đồ tốt giúp bạn đến đúng căn nhà. Nó không kiểm tra hộ hệ thống điện trong nhà.
5. Obsidian Skills giúp Agent viết đúng định dạng vault
Repo kepano/obsidian-skills do Steph Ango duy trì cung cấp năm skill theo chuẩn Agent Skills:
obsidian-markdown: tạo và chỉnh sửa Obsidian Flavored Markdown với wikilink, embed, callout và properties.obsidian-bases: làm việc với file.base, gồm view, filter, formula và summary.json-canvas: đọc và tạo file Canvas với node, edge, group và connection.obsidian-cli: tương tác với vault qua Obsidian CLI, kể cả công việc phát triển plugin và theme.defuddle: dùng Defuddle để lấy phần nội dung chính của trang web thành Markdown sạch.
Skill không tự biến một ghi chú dở thành tri thức tốt. Nó giúp Agent dùng đúng “ngữ pháp” của Obsidian. Còn việc note nào đáng giữ, nguồn nào đáng tin và hai ý có thật sự liên quan hay không vẫn cần quy tắc biên tập.
Nếu bạn đã dùng Agent Skills cho công việc khác, nguyên lý này khá quen thuộc: thay vì nhét hướng dẫn dài vào mỗi prompt, bạn đóng gói quy trình thành skill có thể dùng lại. Bài xây dựng phòng marketing bằng Agent Skills giải thích sâu hơn về cách tổ chức loại năng lực này.
6. Cách dựng bản thử nghiệm an toàn
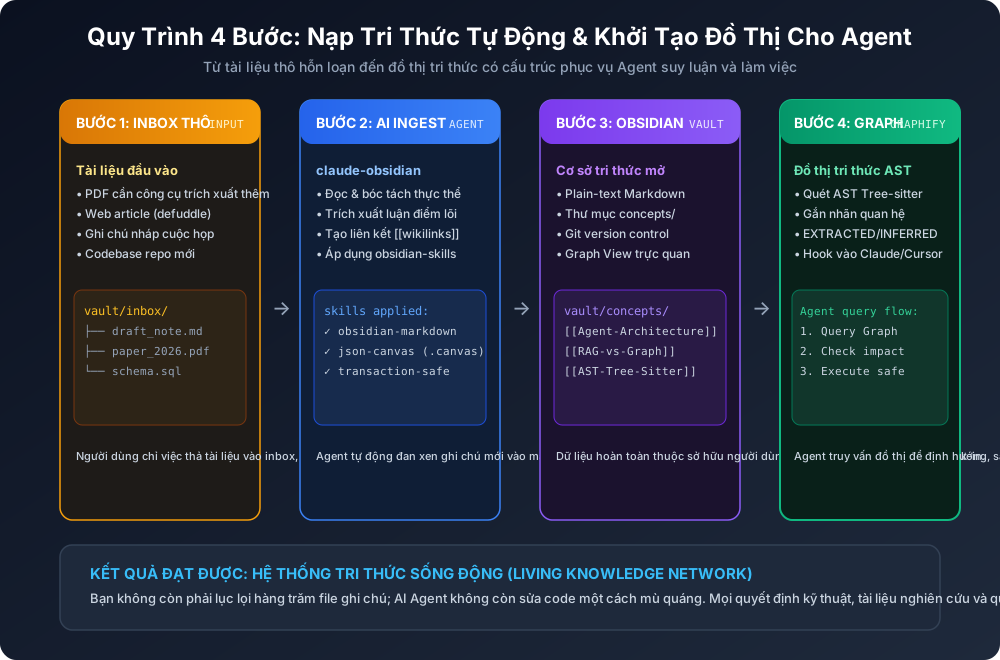
Đừng bắt đầu bằng toàn bộ kho tài liệu mười năm. Hãy chọn một repo hoặc một dự án nhỏ đủ quen để bạn nhận ra khi Agent hiểu sai.
Bước 1: Tạo vault và điểm khôi phục
AI-Second-Brain/
├── inbox/       # Nguồn mới, chưa xử lý
├── sources/     # Bản gốc được giữ lại
├── notes/       # Ghi chú đã biên tập
├── projects/    # Ngữ cảnh theo dự án
└── maps/        # Mục lục và bản đồ nội dung
Khởi tạo Git nếu dữ liệu phù hợp để lưu trong repository. Không commit khóa API, thông tin đăng nhập hoặc tài liệu nhạy cảm lên remote. Nếu chưa quen Git, sao lưu cả thư mục trước khi cho Agent ghi hàng loạt.
Bước 2: Cài claude-obsidian hoặc liên kết skill cho Agent đang dùng
Với Claude Code, các lệnh cài chính thức hiện tại là:
claude plugin marketplace add AgriciDaniel/claude-obsidian
claude plugin install claude-obsidian@agricidaniel-claude-obsidian
Sau đó mở Claude Code trong vault và chạy /claude-obsidian:wiki để xem trước cấu trúc. Trên Windows, dự án khuyến nghị dùng WSL cho các thao tác ghi vào vault. Codex và một số Agent khác dùng script setup-multi-agent.sh của repo để xem trước rồi áp dụng skill; hãy đọc hướng dẫn theo đúng host thay vì sao chép thư mục .claude một cách máy móc.
Bước 3: Cài Graphify và lập chỉ mục
# Cài CLI trong môi trường riêng
uv tool install graphifyy
# Hoặc: pipx install graphifyy

# Chạy trong thư mục repo hoặc vault
graphify install --project

# Nếu dùng Codex
graphify install --project --platform codex

# Lập chỉ mục code cục bộ, không dùng backend AI
graphify extract . --code-only
Nếu cần đưa cả tài liệu và media vào graph, hãy chọn backend rõ ràng trước khi chạy. Graphify có thể dùng nhà cung cấp đám mây hoặc Ollama cục bộ. Kiểm tra biến môi trường và thông báo backend để biết dữ liệu đang được xử lý ở đâu.
Bước 4: Thử một vòng ingest nhỏ
Đặt một bài viết Markdown hoặc transcript văn bản vào inbox/. Giữ PDF cho đến khi bạn đã cấu hình công cụ trích xuất phù hợp. Với claude-obsidian, chạy lệnh ingest không kèm đường dẫn để hệ thống xem nội dung trong inbox:
/claude-obsidian:wiki-ingest
/claude-obsidian:wiki-lint

# Sau khi graph đã được tạo hoặc cập nhật
graphify query "authentication flow"
graphify path LoginHandler SessionStore
Đọc bản kế hoạch trước khi cho phép ghi. Sau khi hoàn tất, kiểm tra note mới, liên kết nguồn và diff. Nếu Agent tạo mười note nhưng bạn không biết note nào đáng tin, hệ thống vừa sản xuất thêm việc chứ chưa sản xuất thêm tri thức.
7. Khi nào nên dùng từng mảnh ghép?
| Nhu cầu | Công cụ nên bắt đầu | Lý do |
|---|---|---|
| Ghi chú cá nhân có liên kết và dễ chuyển đổi | Obsidian | Markdown cục bộ, mở được bằng nhiều công cụ |
| Biến nguồn thô thành wiki có dẫn nguồn | claude-obsidian | Có workflow capture, query, save, lint và transaction |
| Hiểu quan hệ trong codebase lớn | Graphify | AST cục bộ và đồ thị caller/import/inherit có thể truy vấn |
| Tìm đoạn văn gần nghĩa trong kho tài liệu lớn | Vector RAG | Semantic retrieval vẫn phù hợp với câu hỏi nội dung mở |
| Tìm chính xác một tên hoặc chuỗi cấu hình | ripgrep | Nhanh, dễ kiểm tra và không cần lập chỉ mục phức tạp |
Bạn không cần lắp cả kiến trúc ngay ngày đầu. Một vault sạch và một quy tắc nguồn tốt thường có giá trị hơn một knowledge graph rất đẹp nhưng chứa đầy ghi chú không rõ xuất xứ.
8. Năm lỗi dễ biến Second Brain thành bãi chứa mới
- Nạp mọi thứ vào inbox: Agent không thể tự biết tài liệu nào quan trọng với mục tiêu của bạn. Hãy đặt tiêu chí nhận nguồn trước.
- Nhầm suy luận với bằng chứng: cạnh
INFERRED, note do Agent viết và câu trả lời từ model đều cần đường quay về nguồn. - Cho Agent ghi hàng loạt khi chưa có backup: transaction giúp giảm rủi ro, nhưng không thay thế bản sao lưu độc lập.
- Quên ranh giới dữ liệu: local file vẫn có thể được gửi tới model đám mây. Dữ liệu nhạy cảm cần chính sách riêng.
- Đòi một công cụ thay thế mọi công cụ: Graphify không thay grep, knowledge graph không thay test, Obsidian không thay tư duy biên tập.
Quy tắc vận hành gọn nhất là: Agent đề xuất, nguồn chứng minh, diff cho thấy thay đổi và con người quyết định.
9. Câu hỏi thường gặp
Graphify có cần GPU không?
Phân tích code bằng Tree-sitter chạy trên CPU và không yêu cầu GPU. Nếu bạn chọn backend AI cục bộ để trích xuất ngữ nghĩa từ tài liệu hoặc media, yêu cầu phần cứng phụ thuộc vào model và backend đó.
Graphify có thay Vector RAG không?
Không phải trong mọi trường hợp. Graphify mạnh ở quan hệ cấu trúc và đường đi giữa thực thể. Vector RAG vẫn hữu ích cho truy vấn ngữ nghĩa trên văn bản. Một hệ thống có thể dùng cả hai nếu bài toán cần.
Dữ liệu có hoàn toàn ở trên máy không?
Code-only Graphify có thể chạy cục bộ. Vault Obsidian cũng nằm trên máy. Nhưng khi Claude Code hoặc backend đám mây đọc nội dung, dữ liệu liên quan được gửi tới nhà cung cấp tương ứng. Muốn xử lý hoàn toàn cục bộ, bạn phải chọn backend local và kiểm tra cấu hình thực tế.
Có nên dùng GitHub private để đồng bộ vault?
Có thể, nhưng private repository không biến dữ liệu nhạy cảm thành dữ liệu an toàn tuyệt đối. Không commit secret; kiểm tra dung lượng, chính sách công ty và cách xử lý file đính kèm. Obsidian Sync, Git hoặc giải pháp đồng bộ khác đều có đánh đổi riêng.
Kết luận: xây bản đồ trước khi yêu cầu AI chạy nhanh hơn
Second Brain cho AI Agent không bắt đầu từ một plugin. Nó bắt đầu từ một quyết định đơn giản: dữ liệu phải có nguồn, cấu trúc phải đọc được và mọi thay đổi phải kiểm tra được.
Obsidian giữ kho kiến thức ở dạng mở. claude-obsidian giúp biến nguồn thô thành wiki có liên kết. Graphify giúp Agent nhìn thấy quan hệ mà tìm kiếm văn bản thuần túy dễ bỏ qua. Khi ghép đúng, ba mảnh này giúp AI định hướng tốt hơn. Chúng không bảo đảm AI không sai.
Hãy thử trên một dự án nhỏ, kiểm tra từng note và từng cạnh quan hệ, rồi mới mở rộng. Một bản đồ chưa hoàn hảo nhưng được kiểm chứng vẫn tốt hơn một “bộ não thứ hai” đầy tự tin mà không ai biết nó học từ đâu.
Tài liệu kỹ thuật đã đối chiếu
- Graphify-Labs/graphify: cơ chế AST, nhãn cạnh, lệnh cài đặt, backend và giới hạn dữ liệu.
- AgriciDaniel/claude-obsidian: workflow LLM Wiki, transaction, giới hạn PDF và hướng dẫn Windows.
- kepano/obsidian-skills: năm skill và cách tích hợp theo chuẩn Agent Skills.